Apa Itu Algoritma AI?
Algoritma AI adalah prosedur komputasi yang digunakan untuk mengolah data, menemukan pola, dan menghasilkan prediksi atau keputusan. Setiap algoritma memiliki asumsi, kebutuhan data, dan jenis masalah yang berbeda.
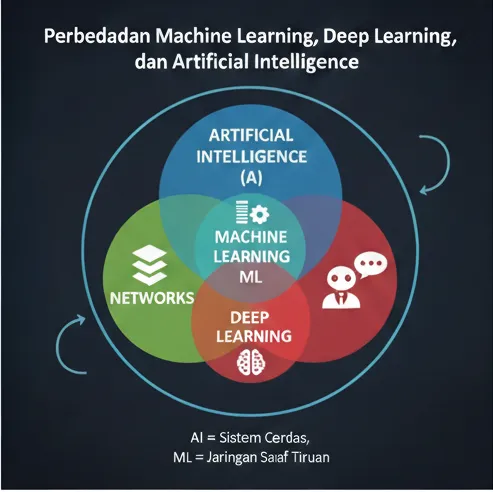
Istilah “algoritma AI” sering digunakan untuk menyebut algoritma machine learning. Keduanya berkaitan, tetapi tidak identik. AI juga dapat memakai aturan, pencarian, atau teknik optimasi yang tidak melalui proses pembelajaran data. Lihat perbedaan AI, machine learning, dan deep learning untuk memahami hubungannya.
Berikut sepuluh algoritma yang umum dipelajari dan digunakan dalam proyek machine learning.
1. Linear Regression
Linear Regression memodelkan hubungan antara variabel input dan nilai numerik yang ingin diprediksi. Algoritma mencari garis atau bidang yang meminimalkan selisih antara prediksi dan nilai aktual.
Metode ini cocok sebagai model awal untuk perkiraan penjualan, konsumsi energi, atau harga properti ketika hubungan datanya relatif linear. Hasilnya mudah dijelaskan, tetapi kurang sesuai untuk pola yang sangat kompleks tanpa pengolahan fitur tambahan.
2. Logistic Regression
Logistic Regression memperkirakan probabilitas suatu data masuk ke kelas tertentu. Walaupun namanya mengandung kata regresi, metode ini biasanya digunakan untuk klasifikasi, terutama klasifikasi biner.
Contoh penggunaannya meliputi prediksi pelanggan berhenti berlangganan, kemungkinan transaksi bermasalah, atau email dibuka. Koefisien model dapat membantu menunjukkan arah pengaruh fitur terhadap prediksi.
3. Decision Tree
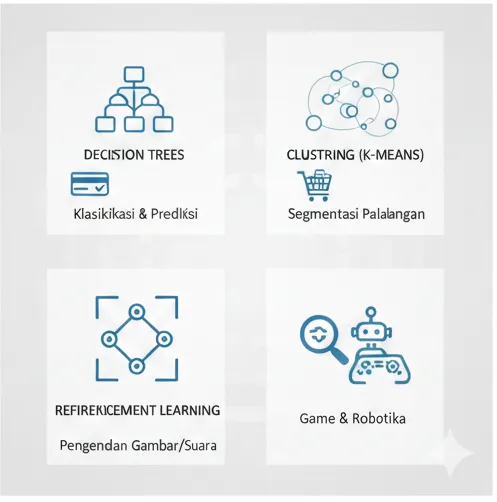
Decision Tree membuat prediksi dengan membagi data melalui serangkaian kondisi bercabang. Setiap simpul menguji suatu fitur, sedangkan cabang mengarah pada pengujian atau hasil berikutnya.
Algoritma ini dapat menangani klasifikasi dan regresi serta relatif mudah divisualisasikan. Decision Tree cocok ketika alur keputusan perlu dijelaskan, tetapi pohon yang terlalu dalam dapat menghafal data pelatihan dan gagal bekerja baik pada data baru.
4. Random Forest
Random Forest menggabungkan prediksi dari banyak Decision Tree yang dilatih menggunakan variasi data dan fitur. Untuk klasifikasi, hasil biasanya dipilih melalui voting; untuk regresi, prediksi digabungkan menjadi nilai rata-rata.
Pendekatan ini umumnya lebih stabil daripada satu pohon keputusan. Random Forest banyak digunakan untuk prediksi risiko, klasifikasi pelanggan, dan analisis data tabular. Kekurangannya, hasil gabungan lebih sulit dijelaskan daripada satu Decision Tree.
5. Gradient Boosting
Gradient Boosting membangun model secara bertahap dengan membuat model baru untuk memperbaiki kesalahan model sebelumnya. Implementasi populernya mencakup XGBoost, LightGBM, dan CatBoost.
Algoritma ini sering efektif untuk data tabular, seperti prediksi permintaan, risiko kredit, atau peluang konversi. Kinerjanya dapat tinggi, tetapi pengaturan parameter yang kurang tepat berisiko menyebabkan overfitting dan waktu pelatihan yang tidak efisien.
6. Support Vector Machine
Support Vector Machine atau SVM mencari batas yang memisahkan kelas dengan margin sebesar mungkin. Data terdekat dari batas tersebut disebut support vectors dan berperan penting dalam menentukan posisi pemisah.
Dengan fungsi kernel, SVM juga dapat menangani batas yang tidak linear. Metode ini digunakan untuk klasifikasi teks, gambar, dan data biologis, terutama pada dataset kecil hingga menengah dengan fitur yang sudah dipersiapkan dengan baik.
7. K-Nearest Neighbors
K-Nearest Neighbors atau KNN menentukan hasil berdasarkan sejumlah data terdekat dari input baru. Klasifikasi dilakukan melalui voting tetangga, sedangkan regresi dapat memakai rata-rata nilainya.
KNN sederhana dan tidak membutuhkan tahap pelatihan model yang rumit. Namun, proses prediksi bisa melambat pada dataset besar. Hasilnya juga sensitif terhadap skala fitur, pilihan jumlah tetangga, dan metrik jarak.
8. Naive Bayes
Naive Bayes menggunakan Teorema Bayes untuk menghitung probabilitas kelas berdasarkan fitur yang diamati. Algoritma ini mengasumsikan fitur saling independen pada setiap kelas, sebuah penyederhanaan yang tidak selalu sesuai dengan kondisi nyata.
Meski asumsi tersebut sederhana, Naive Bayes dapat bekerja cepat untuk klasifikasi teks. Contoh penggunaannya adalah penyaringan spam, analisis sentimen dasar, dan pengelompokan tiket dukungan berdasarkan isi pesan.
9. K-Means Clustering
K-Means mengelompokkan data ke dalam sejumlah cluster berdasarkan kedekatannya dengan titik pusat cluster. Algoritma memperbarui anggota dan pusat cluster secara berulang sampai hasilnya stabil atau batas iterasi tercapai.
K-Means digunakan untuk segmentasi pelanggan, pengelompokan dokumen, dan eksplorasi pola data tanpa label. Pengguna harus menentukan jumlah cluster, sedangkan hasilnya dapat berubah akibat nilai awal dan keberadaan pencilan.
10. Neural Network
Neural Network memproses data melalui lapisan unit komputasi yang memiliki bobot dan fungsi aktivasi. Selama training, bobot diperbarui untuk mengurangi selisih antara prediksi dan target.
Jaringan saraf dengan banyak lapisan menjadi dasar deep learning. Variannya digunakan pada pengenalan gambar, pemrosesan bahasa, audio, serta AI generatif. Metode ini mampu menangani pola kompleks, tetapi biasanya membutuhkan data, komputasi, dan proses evaluasi yang lebih besar.
Bagaimana dengan Principal Component Analysis?
Principal Component Analysis atau PCA adalah teknik reduksi dimensi, bukan model prediksi utama. PCA mengubah sekumpulan fitur menjadi komponen baru yang mempertahankan sebanyak mungkin variasi data.
Teknik ini dapat membantu visualisasi, mengurangi noise, atau menyederhanakan input sebelum model dilatih. Karena fungsinya menyiapkan representasi data, PCA sering dipakai bersama algoritma lain.
Cara Memilih Algoritma AI yang Tepat
Algoritma sebaiknya dipilih berdasarkan tujuan, karakteristik data, risiko kesalahan, dan biaya penerapan. Langkah praktisnya meliputi:
- Tentukan jenis output. Gunakan klasifikasi untuk kategori, regresi untuk angka, dan clustering untuk mencari kelompok tanpa label.
- Periksa karakteristik data. Nilai ukuran dataset, tipe fitur, data kosong, ketidakseimbangan kelas, dan kemungkinan perubahan pola.
- Mulai dari model sederhana. Logistic Regression atau Decision Tree dapat menjadi pembanding sebelum mencoba model yang lebih kompleks.
- Gunakan metrik yang sesuai. Akurasi saja tidak selalu cukup; pertimbangkan precision, recall, F1-score, atau galat prediksi sesuai dampak bisnis.
- Uji pada data terpisah. Evaluasi perlu menggunakan data yang tidak dipakai saat training agar kemampuan generalisasi dapat diukur.
- Pertimbangkan operasional. Kecepatan prediksi, biaya komputasi, kemudahan audit, dan pemeliharaan model ikut menentukan pilihan.
Tidak ada algoritma yang selalu unggul untuk setiap dataset. Tim biasanya menguji beberapa kandidat dalam kondisi evaluasi yang sama, lalu memilih model dengan keseimbangan performa dan kebutuhan operasional terbaik.
Kesimpulan
Algoritma AI dan machine learning memiliki fungsi berbeda untuk klasifikasi, regresi, clustering, serta pemrosesan pola kompleks. Linear dan Logistic Regression menawarkan dasar yang mudah dijelaskan; model berbasis pohon cocok untuk banyak data tabular; K-Means mencari kelompok; sedangkan Neural Network menangani pola yang lebih kompleks.
Pemilihan metode perlu dimulai dari masalah, bukan popularitas algoritmanya. Setelah algoritma dipilih, kualitas data, validasi, dan pemantauan hasil tetap menentukan apakah model benar-benar berguna saat diterapkan.